

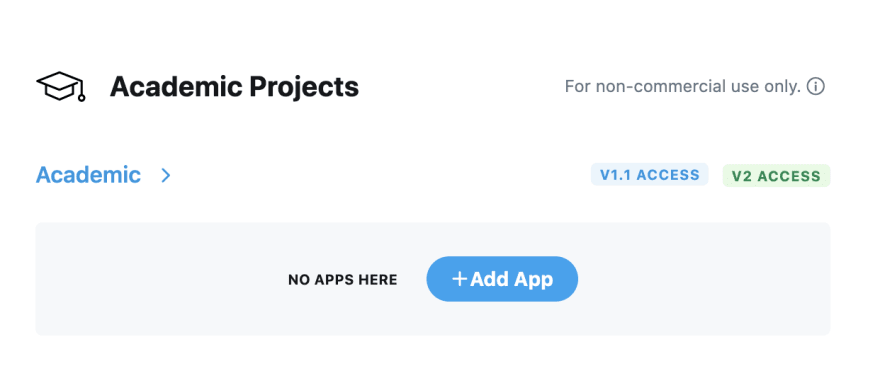
 次に、既存の App を選択してプロジェクトに接続できます (下図のとおり) 。
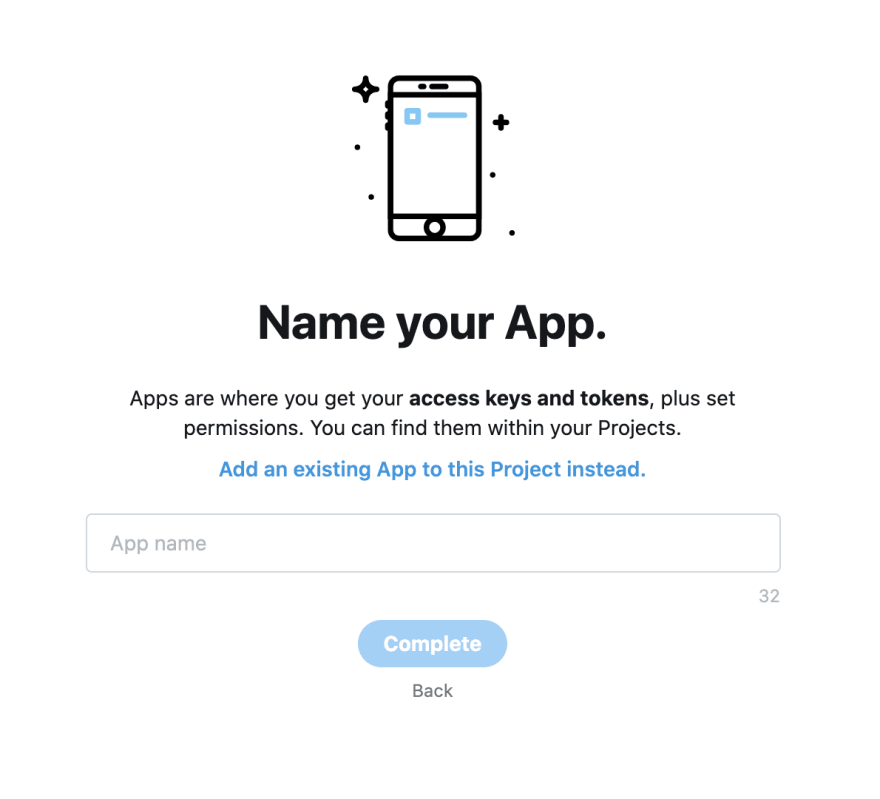
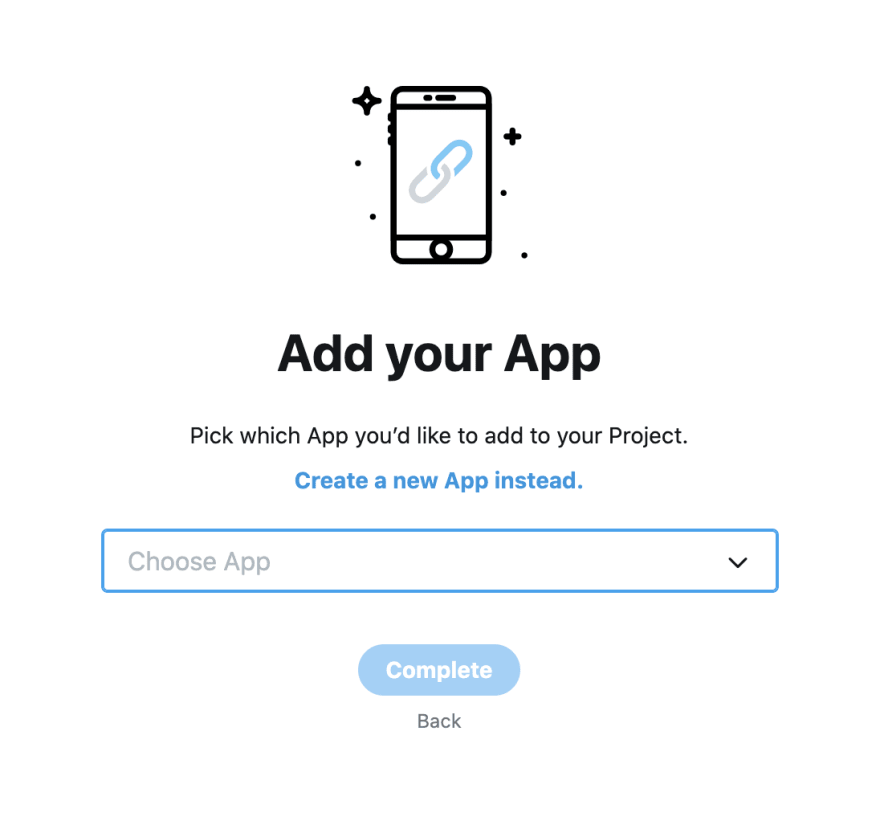 または、新しい App を作成して名前を付け、「Complete」をクリックすることで、
新しい App を Academic Project に接続することもできます。
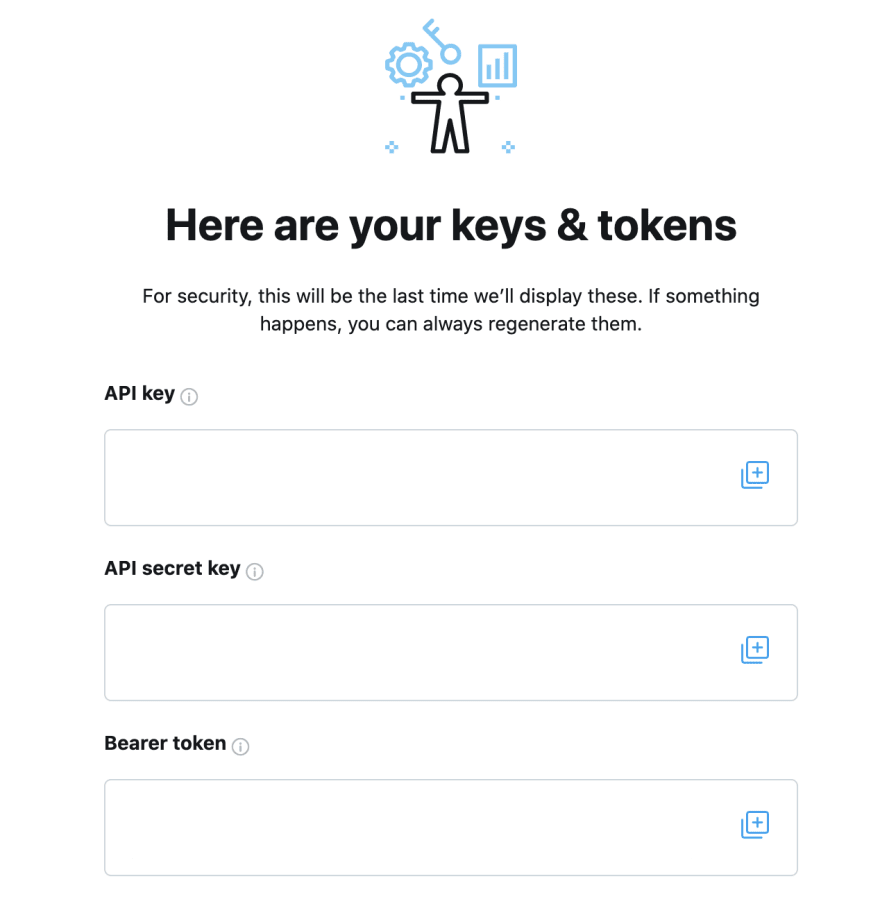
 これにより API キーと
Bearer Token
が発行され、これらを使用してフルアーカイブ検索エンドポイントに接続できるようになります。
 注意
上記のスクリーンショットではキーは非表示になっていますが、
ご自身の Developer Console では API Key、API Secret Key、
および Bearer Token の実際の値を確認できます。
これらのキーと Bearer Token は、フルアーカイブ検索エンドポイントを呼び出す際に必要になるため、
必ず保存しておいてください。
以下の cURL コマンドは、@XDevelopers のアカウントから過去の投稿を取得する方法を示しています。$BEARER_TOKEN を自分のベアラートークンに置き換え、リクエスト全体をターミナルに貼り付けてから “return” キーを押してください。
max_results パラメータを使用し、以下のように 1 リクエストあたり最大 500 件の投稿まで指定できます。
クエリの構築 上記の呼び出し例から分かるように、
query パラメータを使用すると、
検索したいデータを指定できます。たとえば、covid という単語、または
coronavirus という単語を含むすべての投稿を取得したい場合は、
括弧の中で OR 演算子を使用し、クエリを
(covid OR coronavirus) のように指定できます。この場合、API 呼び出しは
次のようになります。
位置情報付きの過去の投稿を取得する 位置情報付きの投稿とは、市区町村、州、国などの地理情報が付与されている投稿のことです。 位置情報データを含む投稿を取得したい場合は、has:geo オペレーターを使用します。 たとえば、次の cURL リクエストでは、位置情報データを含む @XDevelopers アカウントからの投稿のみを取得します。
place_country 演算子を使用することで、ジオデータを持つ投稿を特定の国に限定できます。以下の cURL コマンドは、米国に紐づく @XDevelopers ハンドルからのすべての投稿を取得します。
next_token が含まれます。この next_token を API 呼び出しに指定することで、そのクエリに対して次に取得可能な投稿を取得できます。この next_token は JSON レスポンス内の meta オブジェクトに含まれており、次のような形式になります。
next_token が利用可能かどうかを確認しつつ、収集したい投稿数にまだ達していない場合は、新しい next_token を各リクエストで指定して full-archive エンドポイントを呼び出し続けることができます。
以下は、full-archive search エンドポイントを利用する際に役立つリソースです。ぜひフィードバックをお寄せください。このエンドポイントに関するご質問は @XDevelopers や community forums までお寄せください。